Cửa sổ ngữ cảnh AI là lượng thông tin một mô hình có thể “đặt lên bàn” để xử lý trong một lượt. Một transcript JSONL vẫn có thể nằm nguyên vẹn trên ổ đĩa, nhưng phiên chat chưa chắc tiếp tục được trên công cụ khác. Trong thử nghiệm thật của Thanh, phiên Claude Code 60,3 MB được Codex tính thành 1.056.505 token khi nhập, trong khi giới hạn đích ghi trong log chỉ là 258.400 token. Nó vượt trần hơn 4 lần và dừng. Một phiên khác chỉ 8,4 MB được nhập ở mức 249.937 token, còn 8.463 token dự phòng; Codex thu gọn xuống khoảng 29.025 token rồi tiếp tục thành công.
Bài viết này là một case study thực tế trên máy của Thanh, dựa trên ba ảnh chụp gốc, transcript JSONL và log nhập phiên. Kết luận chính: dung lượng MB chỉ là tín hiệu cảnh báo; số token thực sự được công cụ đích nạp mới là phép đo quyết định.
Vì sao một phiên chat còn nguyên mà AI vẫn không thể tiếp tục?
Thanh từng nghĩ: Claude Code đã lưu lịch sử trong file JSONL, vậy mang qua Codex thì chỉ cần mở lại và làm tiếp. Về mặt lưu trữ, điều đó không sai. File và các thao tác cũ vẫn còn.
Nhưng lưu trữ được không đồng nghĩa với suy nghĩ tiếp được.
Hãy hình dung ba thứ khác nhau. Transcript JSONL là quyển nhật ký ghi lại mọi việc đã xảy ra. Cửa sổ ngữ cảnh AI là mặt bàn mà mô hình đang dùng. Còn memory, wiki, tài liệu bàn giao hay file trong dự án là tủ hồ sơ ở bên cạnh. Quyển nhật ký có thể dày hàng nghìn trang, nhưng nếu mặt bàn chỉ chứa được vài trăm trang thì bạn không thể đổ toàn bộ lên bàn trong một lần.
Stanford HAI cũng định nghĩa đây là lượng văn bản model có thể cân nhắc khi tạo phản hồi tiếp theo.
Điều này nối với hai bài trước về AI agent làm việc qua nhiều chặng và sự khác nhau giữa trí nhớ và file. File giữ dữ liệu; cửa sổ ngữ cảnh quyết định phần mô hình đang nhìn thấy.
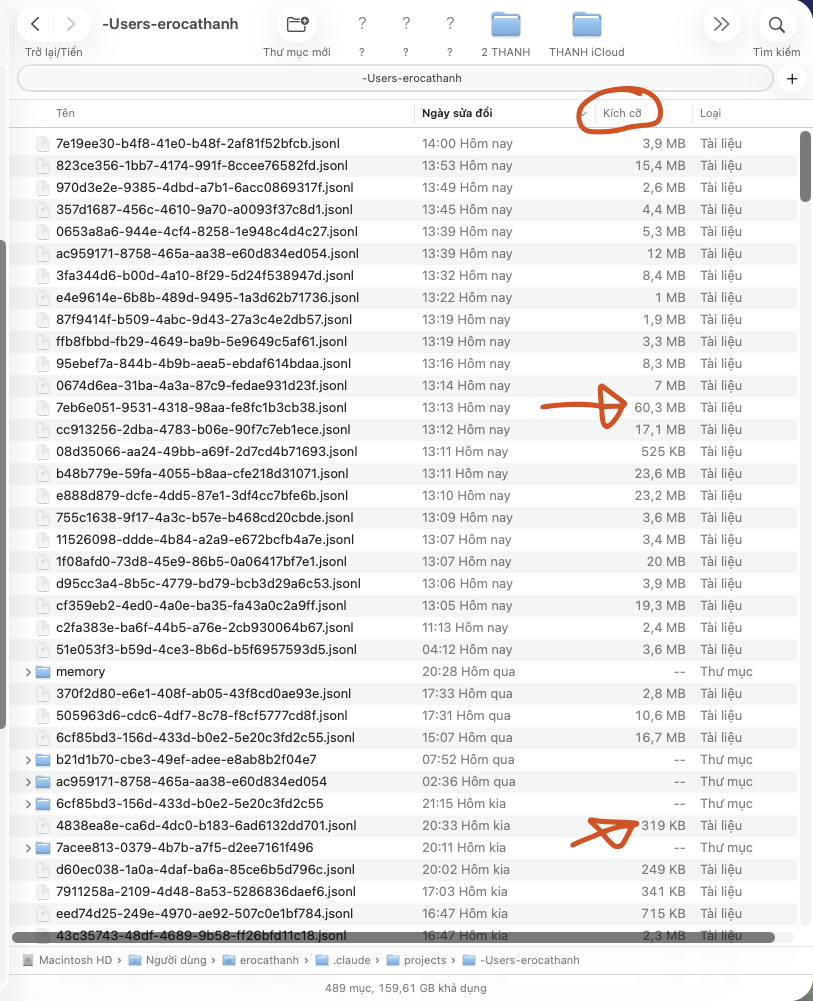
Ca thất bại: 60,3 MB đã vượt cửa sổ ngữ cảnh AI thế nào?
Trong ca đầu tiên, file chính có dung lượng 60,3 MB và chứa năm ranh giới thu gọn. Phiên này trước đó chạy với Opus gần mốc một triệu token trong cấu hình Thanh đã dùng.
Khi nhập sang Codex Desktop, log của phiên mới ghi:
- Số token được nạp: 1.056.505.
- Giới hạn cửa sổ đích: 258.400.
- Tỷ lệ: 4,089 lần giới hạn.
- Kết quả:
context_window_exceeded.
Đây không phải lỗi “file hỏng”. Nó giống như đặt hơn một triệu mảnh thông tin lên chiếc bàn chỉ chịu được 258.400 mảnh. Thu gọn cũng cần đủ chỗ để đọc và tóm tắt đầu vào; khi lịch sử vượt trần quá xa, quá trình có thể không khởi động được.
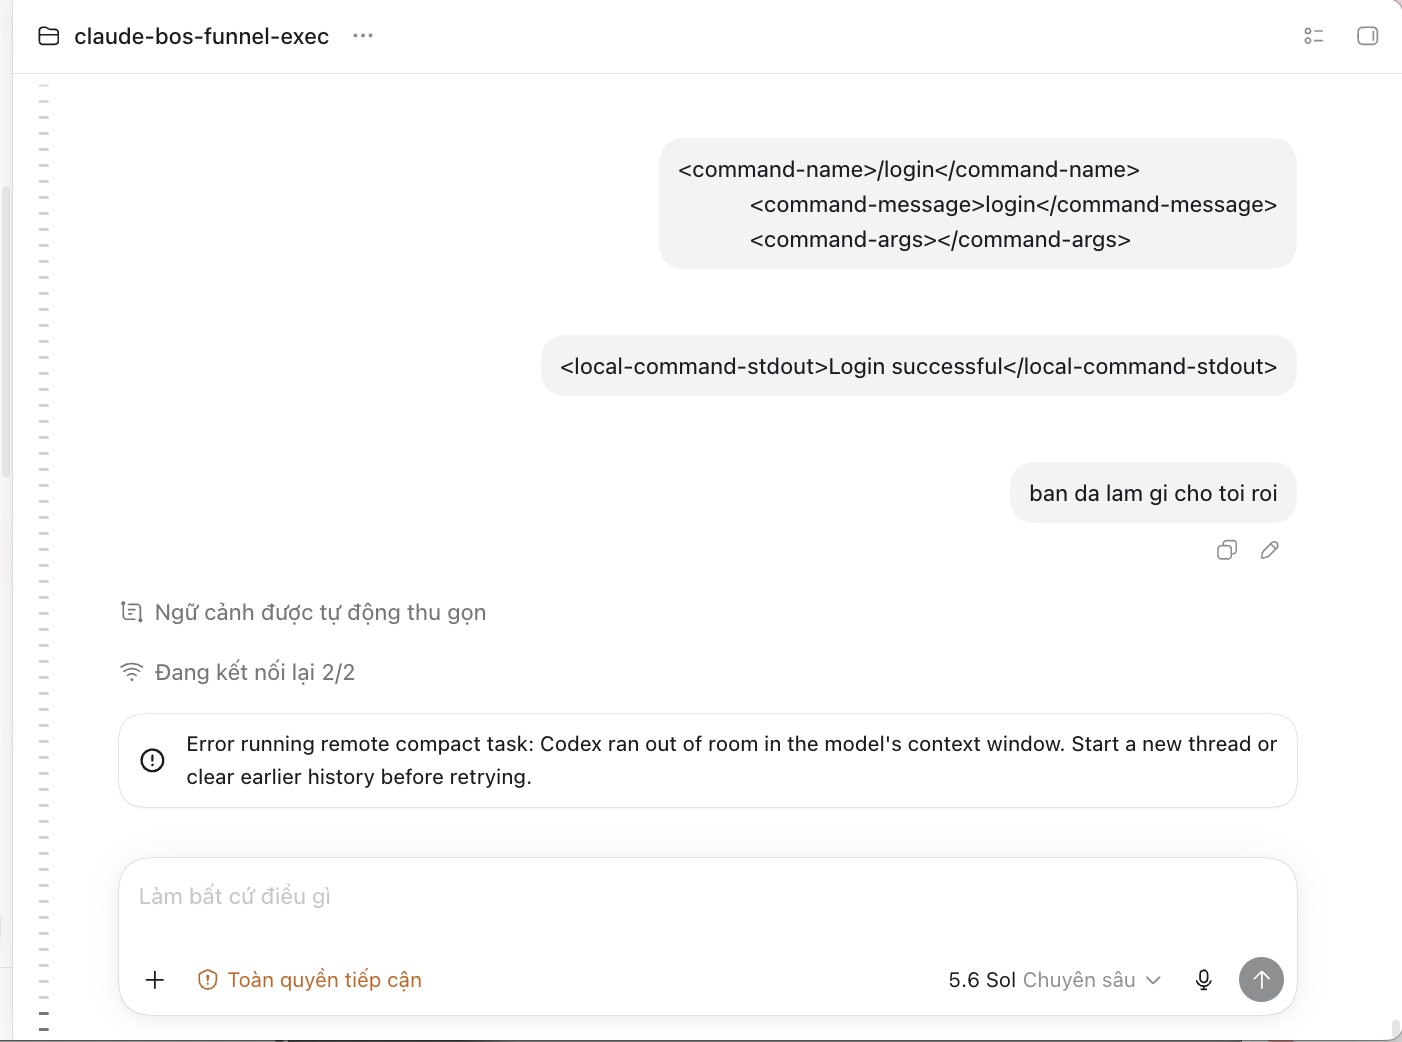
Điều đã đo được là các con số 1.056.505, 258.400 và thông báo lỗi. Điều Thanh suy luận là cơ chế nhập có thể đã dựng lại quá nhiều lịch sử cũ, hoặc Codex đếm token khác Claude. Log chưa đủ để khẳng định nhánh nào. Bằng chứng nói đến đâu, kết luận dừng ở đó.
Ca thành công: vì sao phiên 8,4 MB tiếp tục được?
Ca thứ hai mang tên claude-cohort-chang-4, dung lượng 8,4 MB. Log nhập ghi 249.937 trên giới hạn 258.400 token: khoảng 96,72% mặt bàn và còn 8.463 token dự phòng.
Khoảng trống rất mỏng nhưng chưa vượt trần. Codex thu gọn xuống khoảng 29.025 token, tương đương 11,23% cửa sổ, rồi tiếp tục làm việc.
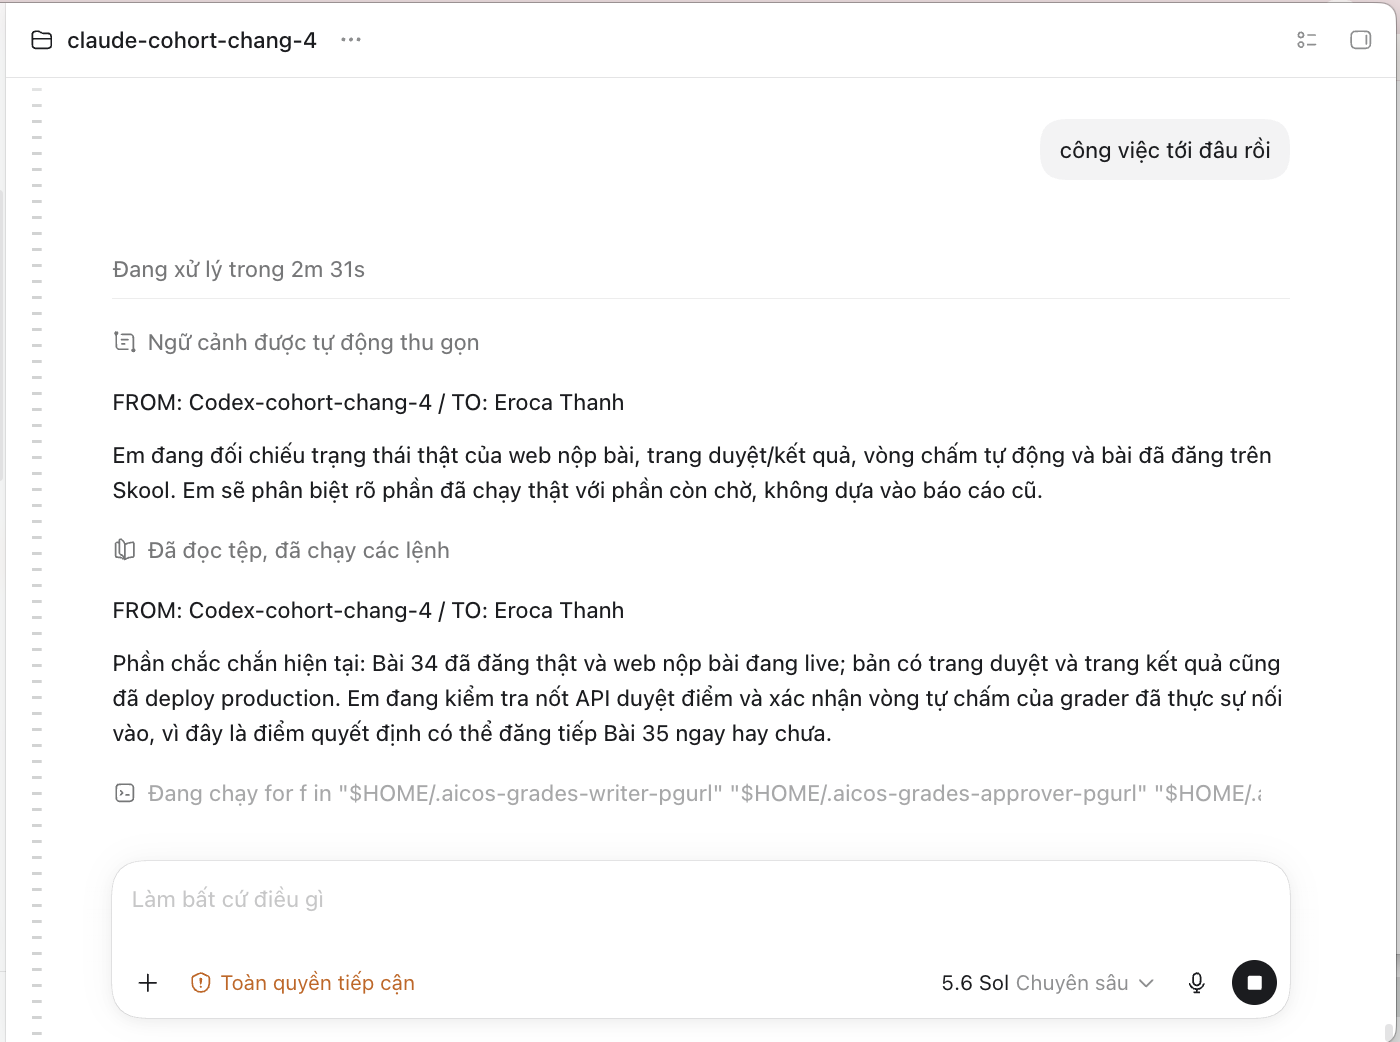
Hai ca tạo ra đường ranh rõ: 249.937 token còn trong trần; 1.056.505 token vượt hơn bốn lần. Khác biệt không nằm ở việc “có JSONL hay không”, mà ở lượng thông tin công cụ đích đưa vào cửa sổ ngữ cảnh AI khi khôi phục.
Anthropic giải thích cửa sổ ngữ cảnh là lượng văn bản tối đa model cân nhắc trong một lần; /compact tóm tắt lịch sử để giải phóng chỗ, và Claude Code có thể tự thu gọn. Xem tài liệu Models, usage, and limits in Claude Code của Anthropic.
File 60 MB có phải lúc nào cũng thất bại?
Không. Đây là chỗ dễ hiểu sai nhất.
Dung lượng MB đo byte trên ổ đĩa; token đo lượng đơn vị văn bản mô hình phải xử lý. File có thể chứa metadata, kết quả công cụ, đoạn lặp, mã nguồn hoặc nhiều nhánh phụ. Hai file cùng 60 MB chưa chắc tạo ra cùng số token, và hai công cụ có thể chọn phần lịch sử khác nhau khi nhập.
Vì vậy, câu đúng không phải “JSONL 60 MB thì Codex không mở được”. Câu đúng là:
Một phiên không thể tiếp tục trực tiếp khi lượng token mà công cụ đích nạp vượt giới hạn ngữ cảnh của mô hình đích và không còn đủ chỗ để thu gọn.
Trần thay đổi theo model và thời điểm. Tài liệu Context windows của Anthropic công bố Opus 4.6 trở lên có thể hỗ trợ một triệu token trong các môi trường được nêu; trang GPT-5.3-Codex của OpenAI công bố giới hạn khác cho model đó. Số 258.400 ở đây là số đo từ đúng phiên khảo sát, không đại diện cho mọi phiên Codex.
Làm sao chuyển một phiên dài giữa Claude Code và Codex an toàn?
Đừng bắt một công cụ mới phải “nuốt” toàn bộ quá khứ để chứng minh nó hiểu dự án. Cách bền hơn là chuyển trạng thái làm việc, không chuyển nguyên khối lịch sử.
- Đo trước khi nhập. Ghi dung lượng JSONL, nhưng quan trọng hơn là tìm số token nhập và giới hạn của model đích nếu log có cung cấp.
- Thu gọn ở nguồn. Khi phiên vẫn còn chạy trong Claude Code, dùng
/compacthoặc yêu cầu tạo bản bàn giao tập trung vào mục tiêu, trạng thái, quyết định, file đã sửa và việc tiếp theo. - Đưa sự thật bền ra file. Quyết định quan trọng nên nằm trong README, tài liệu bàn giao, memory, nhật ký hoặc file trạng thái. Đừng để mọi thứ chỉ sống trong transcript.
- Khởi động phiên đích bằng gói tối thiểu. Cho Codex đọc bản bàn giao và đúng các file cần thiết. Chỉ mở thêm bằng chứng khi công việc yêu cầu.
- Giữ transcript gốc làm hồ sơ. Không xóa hay sửa file JSONL. Nó là bằng chứng để điều tra lại, nhưng không nhất thiết phải trở thành toàn bộ bối cảnh đang hoạt động.
Cách này cũng phù hợp với bài Trí nhớ AI: vì sao AI “quên” bạn dù chung một tài khoản. Trí nhớ bền, file dự án và cửa sổ đang làm việc là ba lớp khác nhau. Khi biết tách chúng, bạn không còn đánh đồng “AI đã từng thấy” với “AI đang nhìn thấy”.
Bài học này thay đổi cách làm việc với AI agent ra sao?
Nỗi đau lớn nhất không phải mất một buổi chat. Nỗi đau là xây cả dự án trên giả định rằng lịch sử chat chính là hệ thống tri thức. Đến lúc đổi model, đổi ứng dụng hoặc cửa sổ đầy, toàn bộ công việc bị kẹt theo một file quá lớn.
Ước mơ đúng không phải một phiên chat kéo dài mãi mãi. Ước mơ đúng là bất kỳ AI agent phù hợp nào cũng có thể tiếp quản công việc từ một trạng thái rõ ràng, kiểm chứng được và đủ nhỏ để đọc.
Với học viên AI CONTENT OS và người học vibe coding, lợi ích rất thực tế:
- Bạn đổi giữa Claude Code và Codex mà không phụ thuộc vào một phiên duy nhất.
- Bạn giảm nguy cơ AI quên quyết định quan trọng sau khi tự thu gọn.
- Bạn giữ transcript nguyên bản cho EEAT và kiểm tra lại, nhưng dùng bản bàn giao ngắn để làm việc.
- Bạn biết lúc nào nên tiếp tục, lúc nào nên mở phiên mới, thay vì cố cứu một cửa sổ đã quá tải.
Nếu mới bắt đầu dùng Claude Code, bạn có thể đọc thêm bài hướng dẫn Claude Code Slash Commands. Nếu đang học cách giao việc, bài 5 việc chủ doanh nghiệp nên giao cho AI trước sẽ giúp bạn bắt đầu từ phạm vi nhỏ và kiểm chứng được.
Thanh cũng đã đóng gói case này thành bộ slide 22 trang về Claude Code, Codex và cửa sổ ngữ cảnh.
Câu hỏi thường gặp
JSONL là gì?
JSONL là định dạng mỗi dòng chứa một đối tượng JSON. Claude Code dùng transcript kiểu này để lưu lịch sử phiên, gồm tin nhắn và dấu vết thao tác. File còn nguyên giúp điều tra và khôi phục dữ kiện, nhưng không bảo đảm công cụ khác có thể nạp toàn bộ trong một lần.
Cửa sổ ngữ cảnh AI có phải là trí nhớ dài hạn không?
Không. Đây là vùng làm việc tạm thời của model trong một lượt. Trí nhớ dài hạn, wiki, tài liệu dự án và file bàn giao nằm ngoài vùng đó; chúng chỉ ảnh hưởng khi được nạp đúng lúc.
Thu gọn có làm mất dữ liệu không?
Thu gọn thay lịch sử chi tiết bằng một bản tóm tắt nhỏ hơn trong vùng làm việc. Transcript gốc có thể vẫn còn trên ổ đĩa, nhưng model sẽ không còn nhìn thấy mọi chi tiết cũ. Vì vậy quyết định quan trọng cần được ghi ra file bền.
Nên chuyển nguyên transcript hay chuyển bản bàn giao?
Hãy giữ nguyên transcript làm bằng chứng, còn phiên mới nên bắt đầu từ bản bàn giao có cấu trúc và những file cần thiết. Chỉ nhập nguyên transcript khi đã đo được nó nằm an toàn trong giới hạn của công cụ đích.
Kết luận: transcript là lịch sử, memory là điều cần nhớ lâu, còn cửa sổ ngữ cảnh AI là mặt bàn đang làm việc. Tách đúng ba lớp này, bạn sẽ không còn ngạc nhiên khi một file vẫn tồn tại nhưng phiên chat không thể tiếp tục.
— Eroca Thanh